NS方程:从物理漩涡到数学推理的ai算法
“What is now proved was once only imagined.” ———— William Blake
“如今已经被证明的事物,曾经也只存在于想象之中。”
序论 | 目录
2026 年 9 月 8 日,OpenAI 公司正式公布:“On the Navier–Stokes Millennium Prize Problem”,并公开:
- 证明论文
- Lean 形式化证明
- 对发现过程的说明
声称其证明的是:3D incompressible Navier–Stokes 可以在有限时间形成奇点
即 Clay 官方问题中的 C,并同时得到 D。而且 OpenAI 特别说明:他们无意凭借这一结果申领 Clay 千禧年大奖。
对于这样一个在广泛学界掀起轩然大波的成就,面临的不只是赞美与憧憬,也有漫天的质疑与指责:NYU 数学家 Tristan Buckmaster 和 Anthropic 数学家 Levent Alpöge 他们在 2026 年 8 月中旬获得了一个关于 Euler 方程爆破(blow-up)的重要结果。这个问题与 Navier–Stokes 密切相关,但不是同一个方程;他们的结果包含外部 forcing(外力)。
关于争议
具体内部详情与争辩这里不详细展开。
同时,也有来自像菲尔兹奖得主 Terence Tao 的担忧:
Terence Tao 的担忧
AI 如果迅速给出最终答案,可能让数学家失去从解决问题的过程中提取方法、洞见和相关结果的机会。
他把这种发展描述为 “quite concerning”。也就是说,他担心的不只是机器取代人,而是数学研究本身的知识生产方式发生变化。
那么,这样一个影响力巨大的事件,在 NS 方程上究竟做出了怎样的贡献?AI 的数学推理能力又发展到何种地步?
虽迟但到。由于学业,笔者不得不搁置撰写,导致不能及时发布这篇文章,不过也给了笔者更多的思考时间来总结一些结论和理解。那么,我们从最基础最底层的视角一步步看(可以略过前两部分)。
目录
- #前置- 从欧拉方程到 NS 方程
- #前置- GPT 模型对于 NS 方程的演技
- #中心课题- AI 数学推理算法与能力
- #附录- 范式与证明测试
- 结语
一 | *从欧拉方程到NS方程
阅读提示
本文着力于 AI 数学推理算法技术。如果不感兴趣于纯物理知识,可以略过前两部分;对于有一定 NS 方程常识的朋友,不影响观感。
实际上,早在 1687 年,牛顿在研究流体中就提出了一个极其重要的数学思想:
流体内部的摩擦力与速度梯度有关。
即类似于
其中
:剪切应力; :黏度; :流速。
这就是后来所谓的牛顿黏性定律。
不过牛顿时代还没有现代意义上的 Navier–Stokes 方程。
真正建立连续介质流体动力学基本方程的人之一是 Leonhard Euler。
基于连续介质假设,1750 年代,欧拉把牛顿第二定律
应用到了连续流体单元。
- 这里,关于连续介质假设,基本思想是:
连续介质假设
流体或固体质点在空间是连续而无空隙地分布的,且质点具有宏观物理量如质量、速度、压强、温度等,都是空间和时间的连续函数,满足一定的物理定律(如质量守恒定律、牛顿运动定律、能量守恒定律、热力学定律等)。
而从建模以及深层的角度看,欧拉时期理想流体的假设可以看成是(本质是同一条假设,但是在 NS 方程中则考虑了线性的切向阻力):
- 面力只有压力。 流体内部任何一个小面元,受到的力都垂直于该面,大小等于压力。
- 没有层间摩擦。 两相邻流体层相互滑动时,不产生任何切向阻力。
再考虑不可压缩的约束,就有所谓的欧拉方程(无外力状态下):
到了 19 世纪,人们又发现欧拉方程没有描述流体内部的摩擦,同时引发了许多错误。为了修正,人们考虑了粘性效应的流体方程,随着纳维和斯托克斯等人的不断优化,最终得到了大名鼎鼎的 NS 方程:
其中
这里不过多阐述推导过程,详细可见维基数学等权威资料。
对于三维的 NS,未知的是一个三维的向量场
难点归根到底,是非线性耦合。即是说:
这一点即主要来自方程中的速度场对自身的输运。
自对流项(self-advection):
将
同时,我们也需要注意到方程中新增的
黏性扩散项:
它将会为方程带来一定的平滑和耗散。
这里也就能触及到 NS 方程的根本难点:爆破?还是平滑解?
明确一点,这里的爆破,指的是几何结构意义上的奇点,即当
速度仍然有限,但变化越来越剧烈。
什么是「爆破」
这里的爆破不是指速度本身发散,而是指速度梯度发散:速度仍然有限,但空间变化越来越剧烈,几何结构意义上出现奇点。
在这里,我们不进一步深入讨论复杂的涡量方程。大致的,写爆破出现在速度梯度中:
左边:梯度变化。
右边:
第一项:
来自非线性增强。
第二项:
来自黏性消散。
如果非线性占优势:
这个方程解:
当:
时:
这就是典型爆破。但是真实 NS 有:
它一直阻止爆炸。
核心矛盾
所以问题就在于:是否存在非线性强于平滑耗散项的情况。
二 | *GPT模型对于NS方程的研究
“A collapsing and stretching vortex creates a finite-time singularity.”
“通过构造一个不断内缩并轴向拉伸的涡旋,使三维 Navier–Stokes 方程在有限时间内形成奇点。”
即是说
径向:
涡旋核心不断向内收缩。
轴向:
涡旋不断被拉长。
当然,这只是一个速度向量场,而并非实际存在的一个物理实体(doge),类似于这样:
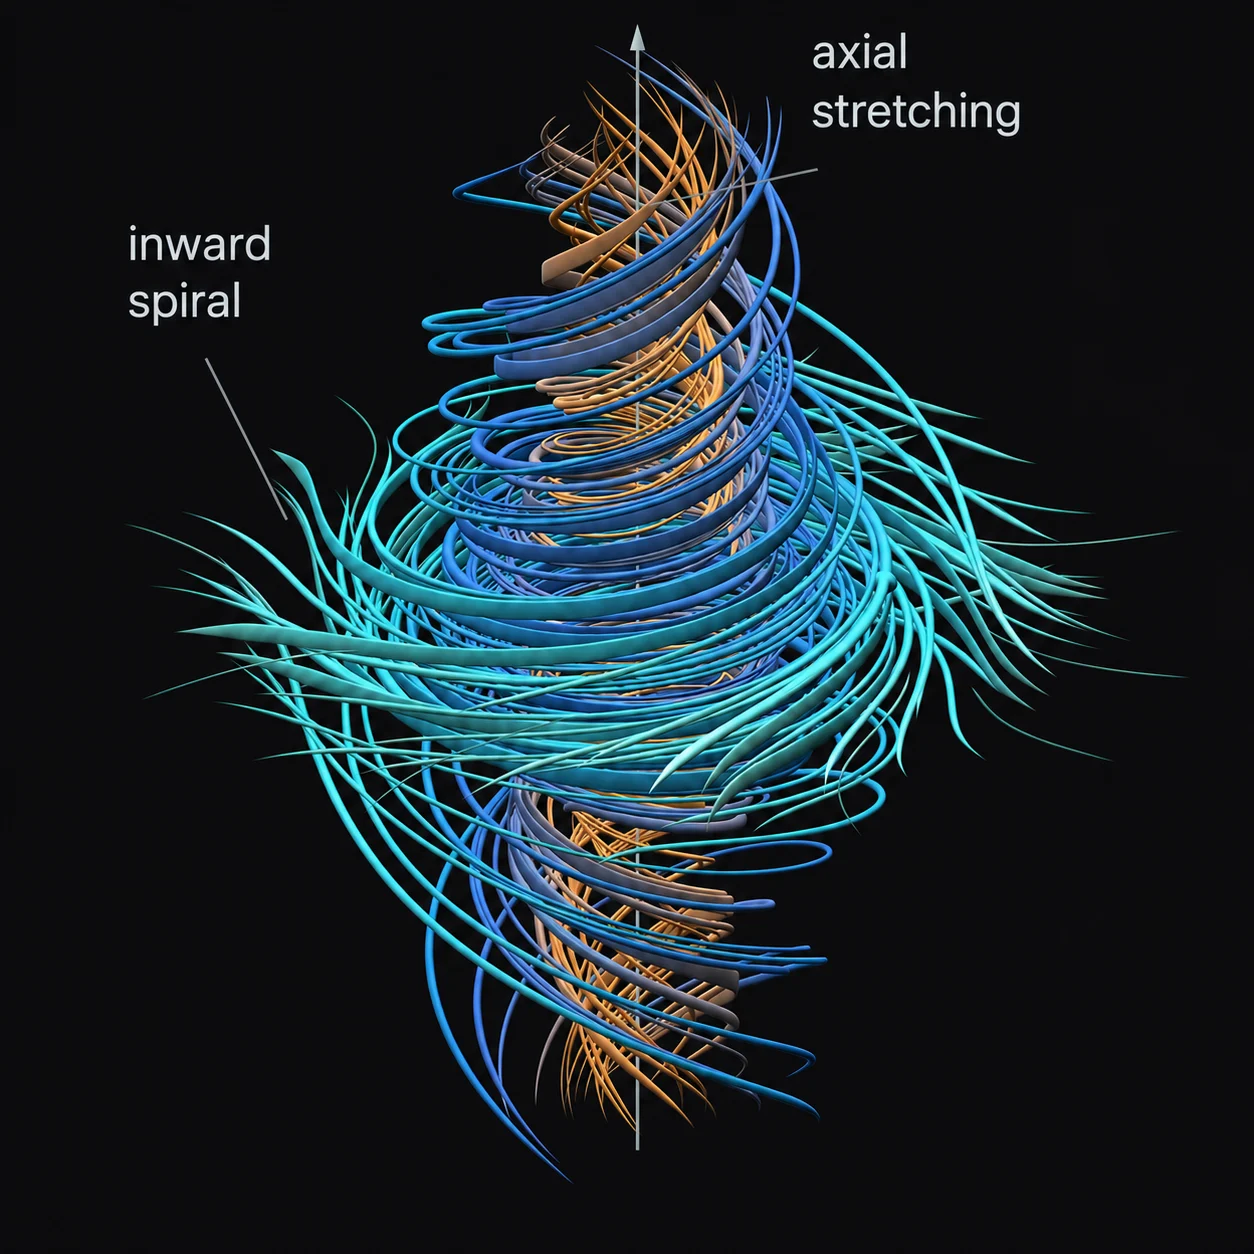
图源:OpenAI — Navier–Stokes solution
定义
3D NS 的涡量方程:
其中最危险的项就是
——涡量拉伸项。
把速度梯度分解:
其中
是应变张量。
那么涡量大小满足的核心增长机制与
有关。
也就是说:
如果速度场的应变恰好沿着涡量方向拉伸涡管,那么涡量本身就会被进一步放大。
这样的正反馈机制带来了解决问题的可能性。
为了保持能量的有限性,OpenAI 构造的关键就是:
但同时
也就是:
局部速度可以无限大,但是区域可以缩得足够快,使总能量仍然有限。
到这里,GPT 就能在此基础上给出具体到速度场的解的表达。详细可以参照证明论文 PDF。
这里不过多阐述。下面,我们正式进入中心课题:
在 NS 方程研究的背景下,当下 AI 的数学推理技术发展到了何种地步?
AI 的数学能力到底是真的那样超越人类专家水平
还是只是困在暴力找反例、超级计算器的老黄牛工作?
三 | AI数学算法技术与能力
「AI 在数学和数学物理中已可以登堂入室(ready for primetime)」
引入 | AI当下的有限域 —— 脉冲函数
在 NS 方程的研究中,我们会定义
爆破背景流:先构造一个已经具有奇异趋势的主流场,再用高速振荡的小尺度修正去消除它产生的奇异残差。residual(残差):来确定离 NS 的解还差的距离(以下把压强按密度归一化):
也就是说,如果
如果有外力
这样,为了满足光滑外力的需求,同时也为了让哪怕在爆破附近的外力具有良好的正则性(光滑程度好),脉冲
加入一个扰动
代入 NS。
关键恒等式是:
这里最重要的就是最后一项:
因为
也就是说:
脉冲自身的二次非线性,会产生一个应力/动量通量。
注意:这里最精妙的点
假设脉冲是
它的平均值是
但是平方(有一些前置条件):
(这里的平方在三维的 NS 中即对应着张量积)
这样,我们既保证了一阶的脉冲为
又利用 NS 的非线性,来让脉冲与自己反应产生的二次效应来弥补残差。
这里困难之处在于,处理复杂的 PDE 残差时:
学术争议
这一点作为解决 NS 方程 CD 情况下存在光滑外力的方法中极其精妙的数学结构之一,同样由人类数学家提供总思路:Alpöge、Buckmaster 在八月就提出了这个研究欧拉方程和 NS 方程的方向,随后 OpenAI 对其进行大规模的协同工作,也导致了不少的舆论风波,称其方法很多抄袭了八月份数学家的工作。有兴趣的朋友自己上 X 看看也无妨。
同时,这也证明了 AI 在数学洞察力和推理中仍有不足,但是能将这种精妙的结构应用到 NS 方程上。
下面,我们来看看 AI 数学推理技术的行为与逻辑:
深入 | AI数学推理的行为与逻辑
熟悉 NP 问题的朋友都知道:
找到一个证明可能要走天文数字条路,但把证明递过去逐行检查是快速的
在模型的训练中,无论是样本数据还是别的形式的训练基础,模型都以人类的打分作为学习因素,但这样的打分在信息滞后的同时又带来了信号的疲弱性。
而在具有数学形式化工具的当下,模型得到的信号是确定而具有较强的正反馈性的。也就证明了:数学推理就 AI 而言,非常适合算法化。
采样 | 选择
许多数学任务无法形式化验证(填空题),这时候可以通过生成多个选项来打分判断:
最基础的方法是 Best-of-N / pass@k:生成
当然,也有类似自洽投票等等的方法来实现基本的选择。同时,模型的自纠正也是一个重要的能力,而自纠正也取决于一个良好的、可信的 critic,来保证模型不会陷入错误的虚假纠正循环中。
把证明变为搜索问题
一旦有形式化验证器(Lean),数学推理就变成一个标准的三元组:
但是,对于成千上万的分支因子(每一步行为的可选项),穷举不可能,所以必须有学出来的先验来决定“往哪试”。经典的引导公式是 UCT(蒙特卡洛树搜索的上置信界):
具体的方案有多种(UCT 的方案被直接搬运到了 AlphaProof 上):
| 方案 | 算法要点 |
|---|---|
| AlphaProof(DeepMind) | Lean + AlphaZero 式自博弈循环:搜索产生证明 → 证明当训练数据 → 策略变强 → 搜索更有效 |
| HTPS(超树搜索,Meta) | 不搜索单条证明,而搜索互相依赖的引理图——因为数学里引理之间是 DAG 结构 |
| DSP(草稿–梗概–证明) | 三段分工:先写自然语言草稿 → 抽出引理骨架 → 逐个形式化证明。把一个大搜索拆成许多小搜索 |
| COPRA 等 | 把当前证明状态当上下文喂给 LLM,失败就回溯换路 |
RL算法 | 更新生成器
RL(Reinforcement Learning,强化学习)我们已经熟知。作为在马尔可夫链状态下寻找最优策略的学习方法,由四个核心要素影响:
- 状态(State):环境的当前信息
- 动作(Action):智能体选择动作的规则
- 奖励(Reward):动作带来的反馈
- 策略(Policy):智能体选择动作的规则
通过 RL,模型可以实现在证明中自己寻找策略、自己完成逻辑闭环的过程。
那么 RL 学习算法的基础形式是策略梯度(REINFORCE):
含义:奖励
问题在于方差极大——所以需要减去一个“基线”。
PPO用学出来的价值网络(critic)当基线。代价:critic 和策略网络一样大,显存翻倍。GRPO(Group Relative Policy Optimization)——最省事的修法。不用 critic,而是对同一个问题采样一组个回答,用组内的统计量当基线:
对于这么一套算法,核心就在于权衡奖励机制中的分配稠密问题。
但是问题就在于,对于难题,过程奖励遭受严重的稀疏信用分配,无法拿到足够的奖励信号。这也是当下亟待解决的问题,笔者在以后会单独出一个合集总结这方面的前沿研究与学习。
这里最重要的是评估指标和学习目标的对齐,决定了是否能有一个好的收获。
下面,我们切入一个具体的实际算法,看看当下研究的主流方向与逻辑。
神经-符号分工
顾名思义,让 AI 自己总结的话:
别让神经网络去推理,只让它决定“往哪儿跳”。
具体的内部机制:
- 一个符号推导引擎(
DDAR)做精确的闭包计算:给定一组已知事实,它能穷尽地推出所有能推的结论。这部分是可判定、可靠、无幻觉的。 - 语言模型只做一件事:提出辅助构造(“在这里加一条线”“补一个圆”)。这类“创造性跳跃”正是符号引擎做不到、而神经网络擅长的。
- 两者交替:LLM 加构造 → 引擎做闭包 → 有新进展继续,没进展再让 LLM 加构造。
笔者看来,这样的算法结构也就利用了优势互补,将需要猜的部分交给神经网络——那正是语言模型最底层最基本的技术之一。
正反馈的逻辑与失效层面
本节开头,我们提到了正反馈机制,也就是 expert iteration(专家迭代)。
即是说,当模型完成搜索证明,又能将证明结果和过程作为数学训练,然后加强自身的证明逻辑,推动搜索证明,这样循环往复,实现正反馈机制的持续。
这样不仅使得 AI 策略加强,也带来了足量的训练库,像数据合成等生成训练库的算法都能为它服务。
五种失效模式
① 空洞为真(vacuous truth)
机制:若形式化命题的假设互相矛盾,则任何结论都成立——命题为“真”,而且极易证。
cause:一个被 RL 优化的 agent 完全可能“发现”这一点,它只需要把假设写得强到自相矛盾。这是形式化数学特有的 reward hacking,而验证器无法识别——它只检查推导,不检查假设是否可满足。
② 语句漂移
机制:形式化的命题弱于论文里的主张。
cause:奖励打在形式化语句上。若声明写弱了,你会得到一个漂亮但答非所问的证明。
③ 把结论塞进假设
机制:用 simp / decide / 自定义定义,让“证明”退化成定义展开。
cause:验证器只看类型正误。
④ sorry / axiom 逃逸
机制:直接留洞或引入公理。
cause:要靠审计扫描发现,而不是靠编译。
⑤ 过程奖励不忠实
机制:PRM(过程奖励模型)给错误步骤打了高分。
cause:稠密信号必然引入可被利用的偏差。
OpenAI - 总结
在实际研究中,GPT 团队用了上万个智能体协作,他们各自的总结与思路汇总成了证明的分布式结果。
而 Codex 作为总领的汇总器,带来了最终的成果。正如披露的:
我们鼓励不同的智能体组探索多种思路。一段时间后,我们使用 Codex 汇总各智能体组最有价值的见解,促进不同组之间的思想交流。这些后续提示词借鉴了智能体自身的中间结果。找到纳维–斯托克斯问题解法的小组正是以这种方式获得引导的
这个协作式的总体不是辩论式的,而是一个种群式的生成器和分层式的汇总器,加上最终的验证构成的证明系统。
具体的协作系统,笔者会在下次的文章中一步步指出。
四 | 附录-范式与证明测试
一个简单的协作式范式是这样的:
1 | # 最小的范式 |
当然,这种复杂的协作式智能体任务当然不会这么简单。
工程上的两个硬问题
- 上下文压缩机制首先就是一个问题。在实际的复杂任务中,上下文长度将会远远大于可用范围,压缩算法的选取与适配将会决定分布结论总结的丢失和保留的平衡性。
- 其次,进程间的通信复杂度在范式代码中几乎不考虑,但实际的多智能体协作却需要巨大的联通成本。
其余的我们可以先不考虑,也可以看出,实际的协作工作是复杂而又巨大代价的,但是带来的收益也是巨大的。
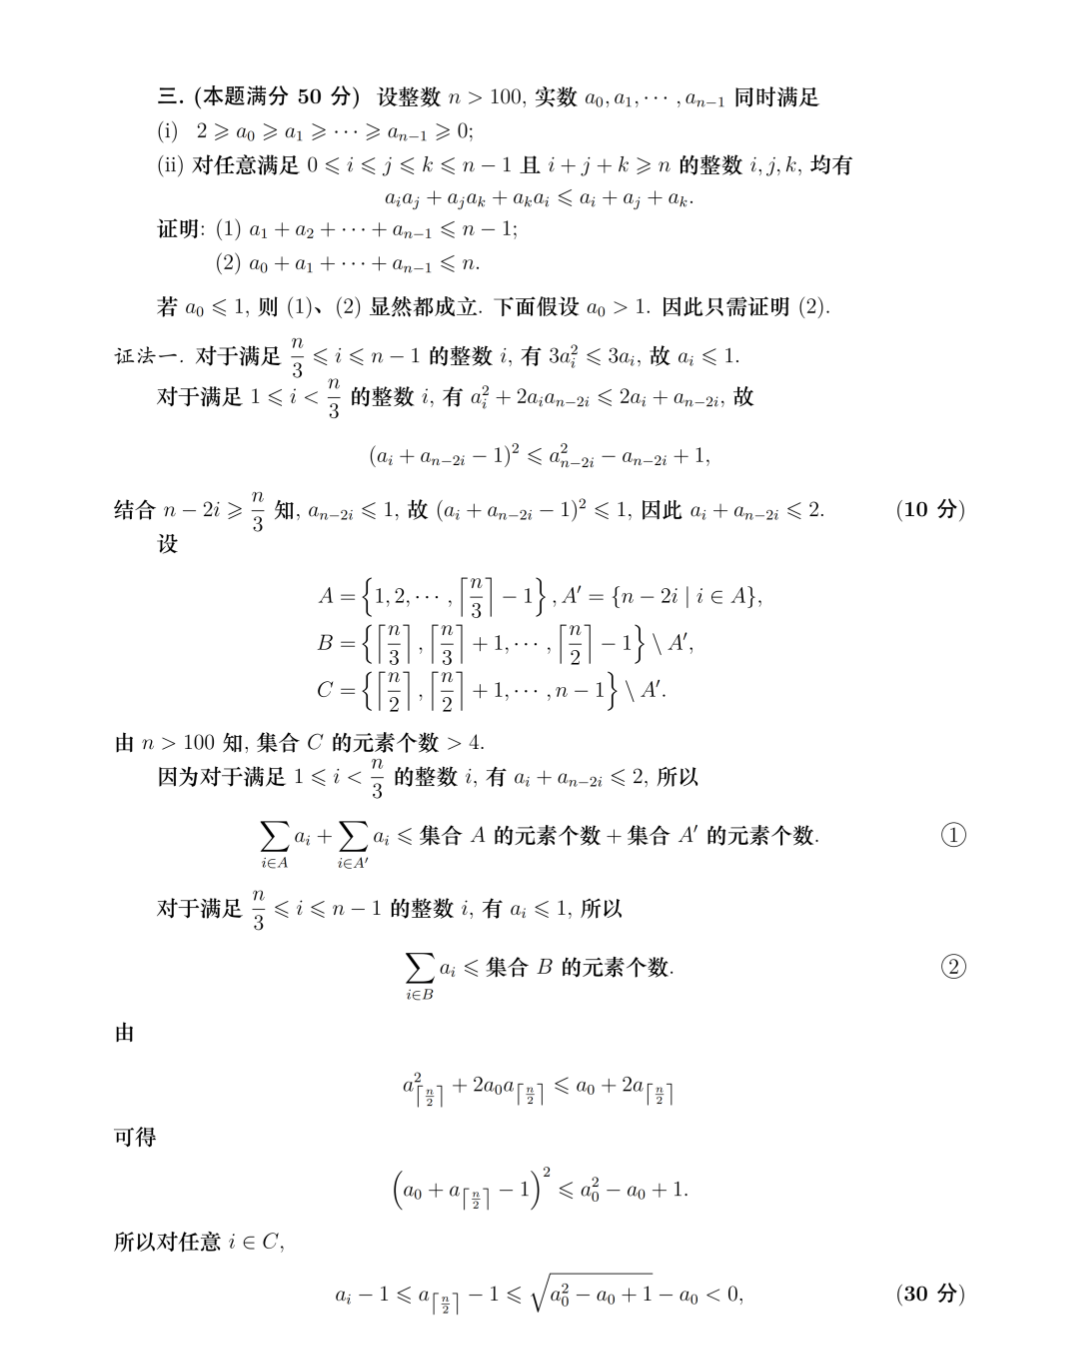
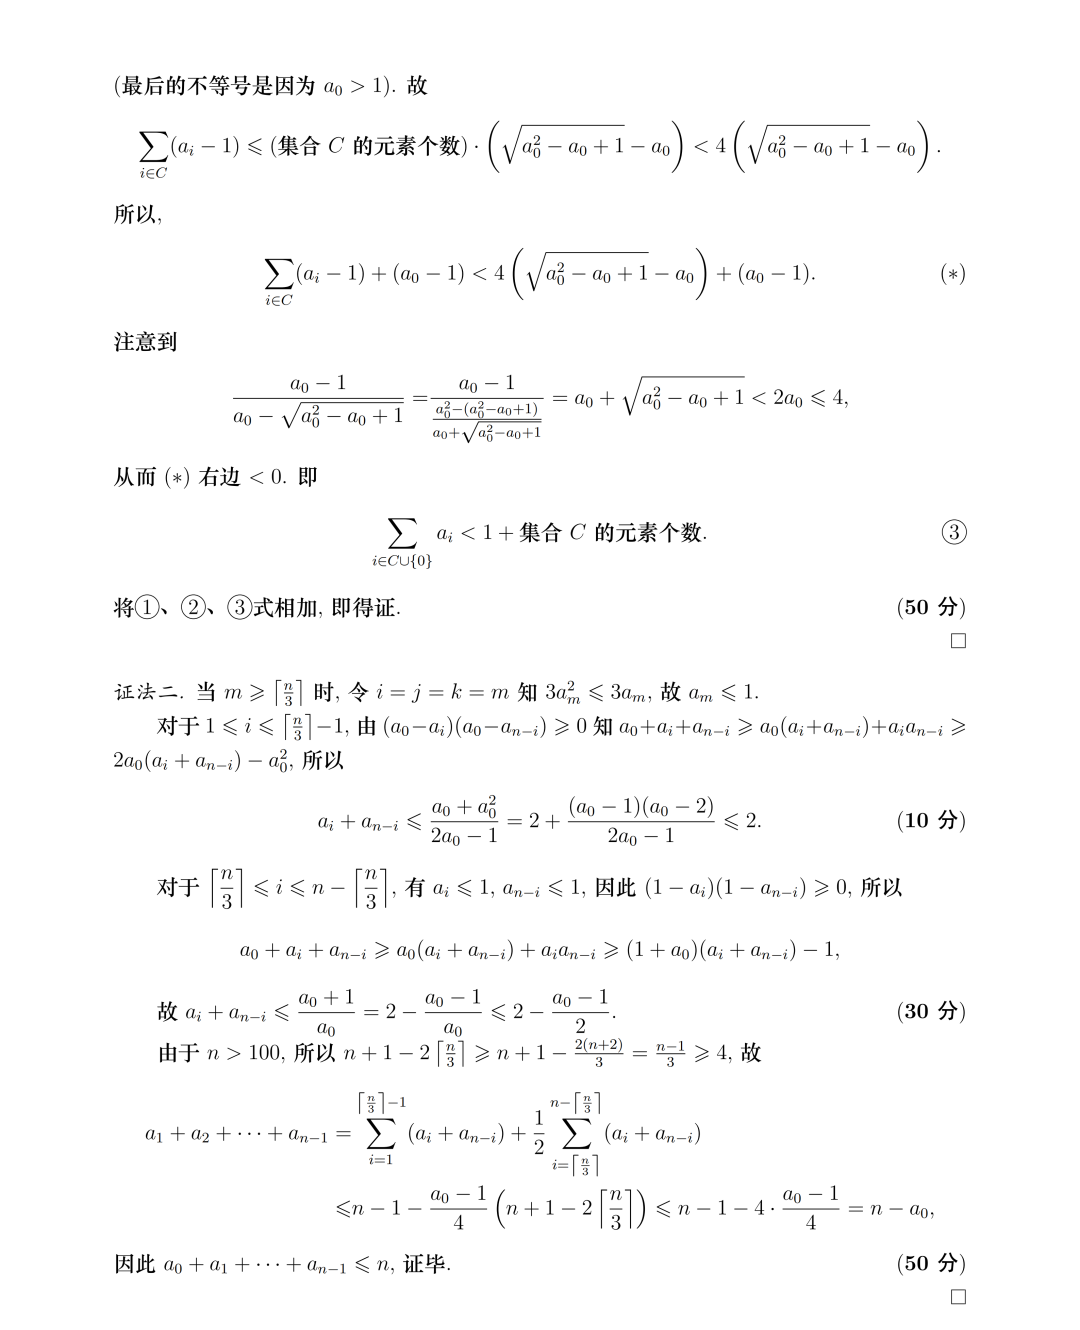
附:一个有趣的测试
我们用高联的二试来测试 AI 的数学能力,以 GPT 为基础。
对于第一题:
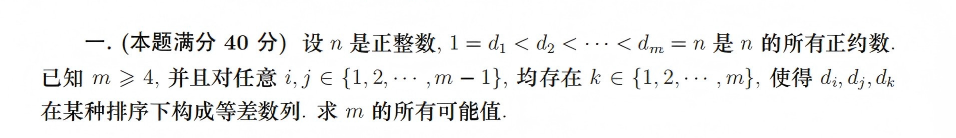
GPT:
前者矛盾,故
故
反之成立,故
正确。
对于第三题:
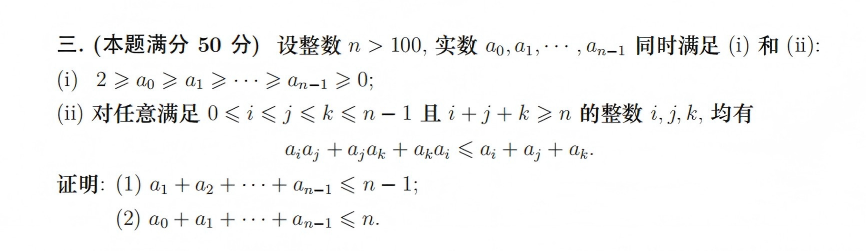
GPT:
利用单调性配对消元,得
即两结论成立。
这是有问题的
正确解答附上:
结语
如上,我们对 AI 在数学物理方面的问题的处理能力有了一定的了解,也对 AI 数学的算法技术有了一定的研究基础。
以后,笔者会更深入地探讨关于 AI 与数学方面的复合问题,单开一个合集。
与之前的 cc-bos 框架,作为人工智能当今的两大课题——技术安全与数学推理,都值得我们的进一步发掘。
支持一下
如果喜欢,就给作者点点赞支持一下(赞赏 1 块钱也可以(doge)。
cc 永远爱你们 ~ _ ~
dddemo-谯楼更声
2026 | 9 | 27 结稿
参考资料
一手材料
[1] OpenAI. On the Navier–Stokes Millennium Prize Problem. 2026-09-08.
- 证明论文(PDF):https://cdn.openai.com/pdf/32d9f210-8b73-45e0-91bc-82a30aef8a9a/navier-stokes.pdf
- 公告页:https://openai.com/zh-Hans-CN/index/navier-stokes-solution/
[2] Fefferman, C. L. Existence and smoothness of the Navier–Stokes equation. Clay Mathematics Institute(千禧年问题官方描述).
算法原始文献
[12] Kocsis, L. & Szepesvári, C. (2006). Bandit based Monte-Carlo planning. ECML 2006, LNCS 4212, 282–293.(UCT)
[13] DeepMind. AI achieves silver-medal standard solving International Mathematical Olympiad problems (2024).(AlphaProof)
[14] Lample, G. et al. (2022). HyperTree Proof Search for Neural Theorem Proving. arXiv:2205.11491(HTPS)
[15] Jiang, A. Q. et al. (2022). Draft, Sketch, and Prove: Guiding Formal Theorem Provers with Informal Proofs. arXiv:2210.12283(DSP)
[16] Thakur, A. et al. (2023). An In-Context Learning Agent for Formal Theorem-Proving. arXiv:2310.04353(COPRA)
[17] Williams, R. J. (1992). Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine Learning 8, 229–256.(REINFORCE)
[18] Schulman, J. et al. (2017). Proximal Policy Optimization Algorithms. arXiv:1707.06347(PPO)
[19] Shao, Z. et al. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300(GRPO)
[20] Trinh, T. H. et al. (2024). Solving olympiad geometry without human demonstrations. Nature 625, 476–482. DOI: 10.1038/s41586-023-06747-5(DDAR / AlphaGeometry)
[21] Lightman, H. et al. (2023). Let’s Verify Step by Step. arXiv:2305.20050(过程奖励模型 PRM)